TL;DR
Les 3 signaux
🔒 Codex chiffre les prompts des sous-agents
 OpenAI a fermé le ticket GitHub #28058 sur Codex : les prompts des sous-agents sont désormais chiffrés 1. La discussion (248 commentaires) indique une préoccupation de sécurité opérationnelle pour les workflows multi-agents. Aucun détail technique sur l’algorithme de chiffrement ou le périmètre exact n’est fourni.
Pourquoi ça compte : si vous déployez des agents qui délèguent à des sous-agents, le chiffrement côté OpenAI empêche l’inspection des prompts intermédiaires — impact direct sur le debugging et l’auditabilité.
💰 OpenAI formalise le ROI des agents
 OpenAI publie un guide « Managing AI investments in the agentic era » qui définit une métrique : « useful work per dollar » 2. Le document explique comment mesurer l’efficacité des workflows agentiques, améliorer l’efficience et scaler les tâches à haute valeur. C’est un cadre de pilotage, pas un benchmark technique.
Pourquoi ça compte : si vous devez justifier un budget agent auprès de votre direction, cette métrique propriétaire devient le standard de facto — préparez-vous à aligner vos dashboards.
🤖 Les agents multi-agents n’explorent pas entre eux
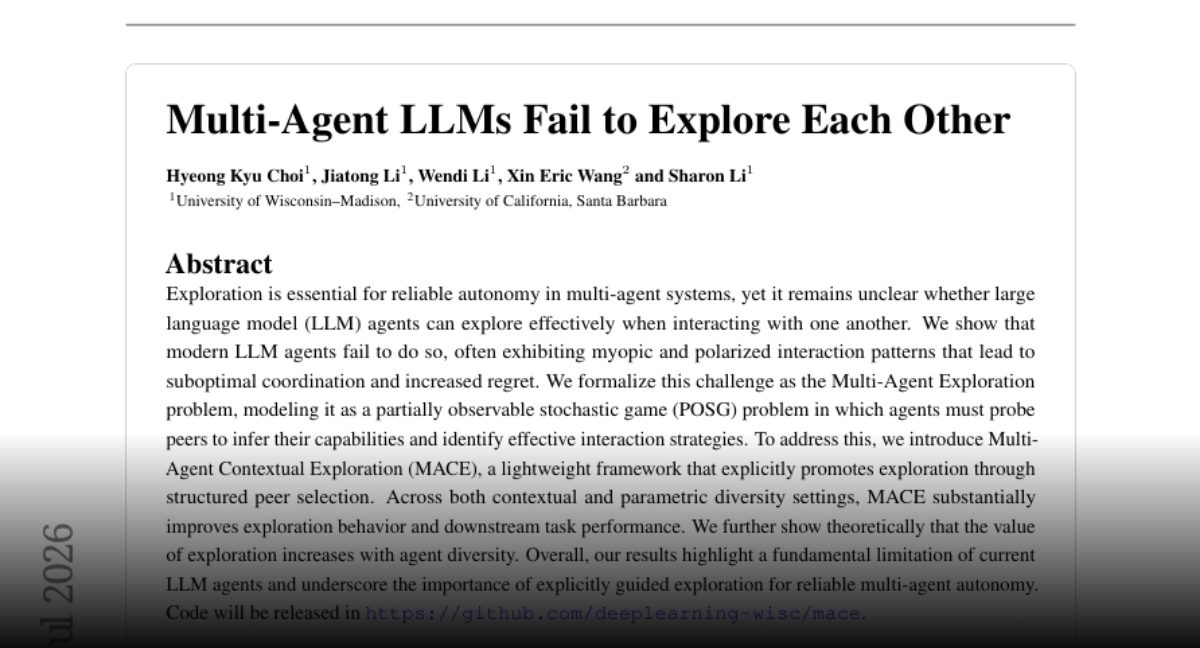 Le paper « Multi-Agent LLMs Fail to Explore Each Other » (arXiv) démontre que les agents LLM modernes adoptent des patterns d’interaction myopes et polarisés, menant à des décisions sous-optimales 16. L’exploration mutuelle, pourtant essentielle à l’autonomie, est absente.
Pourquoi ça compte : si vous concevez des systèmes multi-agents, vous devez compenser ce biais d’exploration par des heuristiques externes — ne comptez pas sur les LLMs seuls pour coordonner.
À retenir
- Chiffrement des prompts sous-agents — Codex crypte les prompts intermédiaires, impactant le debugging des workflows multi-agents 1
- « useful work per dollar » — Nouvelle métrique OpenAI pour justifier les investissements agentiques 2
- Absence d’exploration mutuelle — Les agents LLM multi-agents échouent à explorer entre eux, produisant des décisions sous-optimales 16
Radar Contradictions
Claim : OpenAI affirme que les entreprises peuvent mesurer “useful work per dollar” pour gérer les investissements IA 2. Contre-signal : L’article arXiv 5 montre que les agents LLM appliquent une stratégie “maximum-context-first” inefficace, transformant une édition simple en une tâche lourde, ce qui contredit la notion de travail utile mesurable. Ce que ça change pour un dev : La métrique “useful work per dollar” risque d’être faussée par l’inefficacité intrinsèque des agents, rendant son calcul peu fiable.
Reproduit en 15 min
Repo/Snippet : Clawk – Give coding agents a disposable Linux VM 4 Comment tester :
git clone https://github.com/clawkwork/clawk.git, puis lancerdocker compose uppour démarrer l’API, et exécuter un agent de codage en pointant surhttp://localhost:8080. Prérequis : Docker, Python 3.10+
Track Record
Ce qu’on disait le 2026-06-30 : Agents-A1, un modèle 35B MoE, atteint des performances de niveau trillion de paramètres en scalant l’horizon d’agent 15 Verdict aujourd’hui : en attente. Aucun élément du jour ne mentionne Agents-A1 ni ne confirme ou infirme ses performances. Le papier arXiv 5 montre que les agents LLM peinent encore à évaluer la complexité des tâches, ce qui relativise l’ampleur du scaling annoncé, sans le contredire directement.
Sous le radar
L’item : arXiv 2607.13034v1 – “Do AI Agents Know When a Task Is Simple?” 5 (faible: 0 citations) Pourquoi c’est du signal : Identifie un biais de surconsommation de contexte chez les agents LLM, qui exécutent des relectures inutiles pour une simple édition. Propose une piste de complexité-aware reasoning, directement exploitable pour optimiser les coûts d’inférence.
Donnée manquante
L’annonce : OpenAI annonce ChatGPT Work pour data science et ventes 1213. Ce qui manque : Le coût d’inférence par tâche (ex. “root-cause brief”) n’est pas disclosed. Pourquoi ça compte : Sans coût par requête, impossible de calculer le “useful work per dollar” pour les équipes, pourtant présenté comme métrique clé dans leur propre guide d’investissement 2.
Sources (18) — vérifiées le 15/07/2026 11:15 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | Codex starts encrypting sub-agent prompts | Hacker News | 14 juillet 2026 |
| 2 | How to manage AI investments in the agentic era | OpenAI | 14 juillet 2026 |
| 4 | Show HN: Clawk – Give coding agents a disposable Linux VM, not your laptop | Hacker News | 13 juillet 2026 |
| 5 | Do AI Agents Know When a Task Is Simple? Toward Complexity-Aware Reasoning and Execution | arXiv | 14 juillet 2026 |
| 12 | How data science teams use ChatGPT Work | OpenAI | 14 juillet 2026 |
| 13 | How sales teams use ChatGPT Work | OpenAI | 14 juillet 2026 |
| 15 | Know Before Fix: QA-Driven Repository Knowledge Acquisition for Software Issue Resolution | HF Papers | |
| 16 | Multi-Agent LLMs Fail to Explore Each Other | HF Papers |
Autres lectures (10)
| N° | Publication | Site | Date |
|---|---|---|---|
| 3 | Empowering India’s next generation of innovators with ATL Saathi | Google DeepMind | 13 juillet 2026 |
| 6 | DenseReward: Dense Reward Learning via Failure Synthesis for Robotic Manipulation | arXiv | 14 juillet 2026 |
| 7 | TerraZero: Procedural Driving Simulation for Zero-Demonstration Self-Play at Scale | arXiv | 14 juillet 2026 |
| 8 | PalmClaw: A Native On-Device Agent Framework for Mobile Phones | arXiv | 14 juillet 2026 |
| 9 | FormalAnalyticGeo: A Neural-Symbolic Based Framework for Multimodal Analytic Geometry Problem Generation | arXiv | 14 juillet 2026 |
| 10 | ViHoRec: A Quality-Controlled Vietnamese Hotel Recommendation Dataset and Cold-Start Benchmark | arXiv | 14 juillet 2026 |
| 11 | Celebrating 25 years of visual search innovation | Google AI | 14 juillet 2026 |
| 14 | Blind-Spots-Bench: Evaluating Blind Spots in Multimodal Models | HF Papers | |
| 17 | Xiaomi-Robotics-U0: Unified Embodied Synthesis with World Foundation Model | HF Papers | |
| 18 | Motion4Motion: Motion Transfer Across Subjects at Inference | HF Papers |
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.