TL;DR
Les 3 signaux
🚀 Modèles Flash
la course à l’inférence légère s’intensifie
 GLM-5.3-Flash et Qwen3.8-Flash-Next concentrent l’attention avec respectivement 939 points et 652 points 12. Le positionnement « Flash » des deux modèles indique une focalisation sur la latence et le coût d’inférence. La publication simultanée suggère une concurrence directe sur ce segment.
🧠 La compression 4-bit dépasse le full-precision
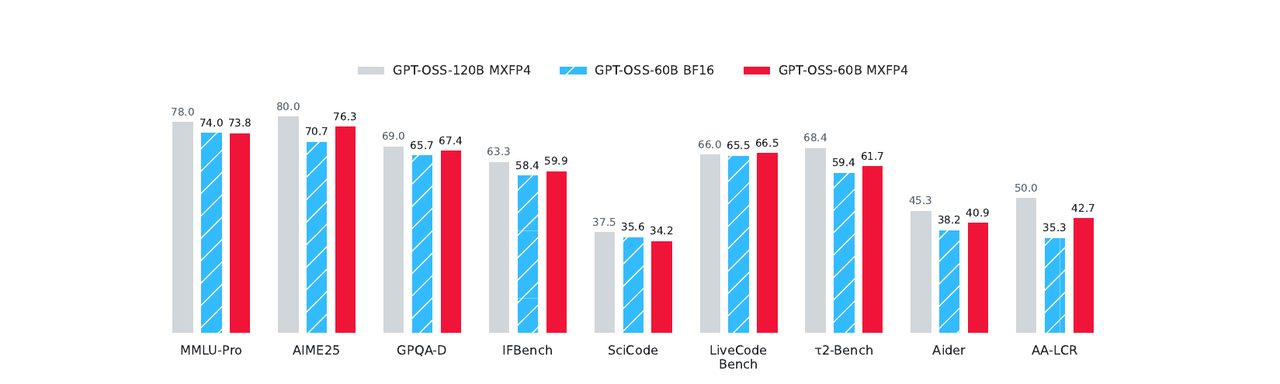 Le blog Hugging Face de MultiverseComputingCAI présente une approche nommée Quantization-Aware Healing : un modèle compressé en 4-bit surpasse son original en full-precision 3. Le terme « healing » suggère un processus de récupération de performance post-quantization, probablement par fine-tuning ciblé ou ajustement adaptatif.
🐍 EVE Online migre enfin vers Python 3
 EVE Online, sur Stackless Python 2.7 depuis 2010, lance sa migration vers Python 3 12. Le jeu tourne sur Stackless Python depuis 2003 et constitue un cas d’étude de Python à l’échelle depuis plus de vingt ans. La migration d’un système de cette ancienneté et de cette taille est un chantier majeur.
À retenir
Tuto du jour
Tuto / Outil : Quantization-Aware Healing 3 Ce qu’on installe : Un modèle compressé en 4-bit qui surpasse son original en précision complète. Prérequis hardware & commande : Non spécifié dans les éléments fournis.
Matos & Infra local
Sujet Matos/Infra : Quantization-Aware Healing, modèle 4-bit surpassant l’original full-precision 3 Constat technique : Un modèle compressé en 4-bit surpasse son équivalent en pleine précision, remettant en cause le compromis habituel entre taille de VRAM et qualité d’inférence. Recommandation dev : Évaluer cette approche pour réduire l’empreinte mémoire locale sans sacrifier les performances.
Fine-Tuning & Quantiz
Technique / Outil : Quantization-Aware Healing, modèle 4-bit 3 Apport : Le modèle compressé surpasse l’original en précision plein format 3 Impact pratique : Réduit la mémoire tout en améliorant les performances, sans perte de qualité 3
Technique / Outil : Group-Shared Low-Rank Approximation 8 Apport : Réduit la croissance quadratique des paramètres des CNN à large noyau 8 Impact pratique : Facilite le déploiement sur appareils mobiles à mémoire limitée 8
RAG & Agents Locaux
Architecture / Outil : TraceML 7
Cas d’usage : Évaluation de la planification humain-agent dans le développement ML autonome, où l’agent révise pipelines et modèles sur des heures de feedback.
Clé de voûte : Analyse empirique des traces d’interaction, pas de vector DB ; stratégie centrée sur la révision itérative et la validation.
Architecture / Outil : JIT-Agent 15
Cas d’usage : Génération automatique de harnais d’agent (mémoire, planification, orchestration d’outils) pour tâches spécifiques.
Clé de voûte : Évolution du harnais en temps réel, sans base vectorielle ; optimisation du protocole d’action.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-08-09 : Qwen3.8 Max passe n°1 de l’agentic index, classement global des modèles 2 Verdict aujourd’hui : partiellement tenu. La famille s’étend avec Qwen3.8-Flash-Next, très discuté sur Hacker News (652 points) 2, mais aucun élément ne confirme le maintien de la position n°1 de Max. Le classement global n’est pas réévalué dans les sources du jour. En attente de confirmation.
Sources (18) — vérifiées le 27/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | GLM-5.3-Flash | Hacker News | 26 août 2026 |
| 2 | Qwen3.8-Flash-Next | Hacker News | 26 août 2026 |
| 3 | Quantization-Aware Healing: a compressed, 4-bit model that outperforms its full-precision original | Hugging Face | 25 août 2026 |
| 7 | TraceML: An Empirical Analysis of Human-Agent Planning in Machine Learning Development | arXiv | 26 août 2026 |
| 8 | Group-Shared Low-Rank Approximation for Mobile-Efficient Pointwise Convolutions in Large-Kernel CNNs | arXiv | 26 août 2026 |
| 12 | EVE Online: The Move to Python 3 Begins! | Simon Willison | 25 août 2026 |
| 15 | JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution | HF Papers |
Autres lectures (11)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.